אני מתרגש באופן לא אופייני לכתוב את הפוסט הזה, כי במשך הרבה זמן היה קשה ללמד איכות נתונים בדרך הנכונה.
היינו צריכים להשקיע כל כך הרבה זמן בצד הטכני: איך להשלים ערכים חסרים, איך להסיר כפילויות, איך לאחד שדות מבולגנים, ואיך להביא דאטה למצב שהכלים בכלל יסכימו לעבוד איתו.
הכישורים האלה עדיין חשובים, אבל פעם הם תפסו את כל השיעור. בזכות מודלי שפה גדולים וסוכני AI, היום זה כבר לא חייב להיות ככה.
כמעט אף פעם לא נשאר לנו מספיק מקום ללמד את החלק החשוב יותר: איך לזהות איזה סוג של כשל אתם באמת רואים, ואיך הכשל הזה מעוות החלטה עסקית.
עכשיו, כש־AI יכול לעזור יותר ויותר עם הצד הטכני, אפשר סוף־סוף להתמקד בחשיבה. ושלמות נתונים היא המקום הנכון להתחיל בו, כי חלק מבעיות הדאטה המסוכנות ביותר בכלל לא נראות כמו תקלה.
הדשבורד שלכם לא טועה. חסר בו חצי מהסיפור.
זה סיפור עתיק כמו הזמן עצמו. התנועה נראתה יציבה. ההזמנות נראו חלשות. הדשבורד היה מסודר, מעודכן ומשכנע מספיק כדי לזמן פגישה על דפי נחיתה, על איכות הפרסום ועל השאלה אם משתמשי אייפון פתאום הפכו לקשים יותר להמרה.
ואז מישהו בדק את גרסת מערכת המעקב. בשיווק חשבו שההמרה במובייל קרסה.
שינוי ב־iOS גרם בשקט לכך שאירועי סשן הפסיקו להירשם. ההזמנות עדיין הגיעו. הסשנים לא. שום דבר בגרף לא נראה שבור באופן ברור. המספרים היו אמיתיים. המסקנה הייתה בדיונית.
זאת שלמות נתונים.
אני מכיר את זה — df.fillna(), נכון?
שלמות נתונים היא לא רק ״האם יש לנו nulls?״. השאלה היא אם הדאטה שנחוץ כדי לענות על השאלה באמת קיים. דאטה יכול להיראות מסודר ועדיין להיות חסר בדיוק את פיסת המציאות שההחלטה שלכם תלויה בה.
זה מה שהופך שלמות נתונים למסוכנת בעידן מודלי השפה.
עוזר AI יכול לעזור לכם למלא שדות חסרים, לכתוב שאילתות לבדיקת הנתונים ולסמן פערים חשודים. מה שהוא לא יכול לעשות במקומכם הוא להחליט אם הדאטה שמולכם מספיק להחלטה שאתם מקבלים.
החלק הזה עדיין דורש שיקול דעת.
הערך החסר המסוכן ביותר הוא זה שאתם לא יודעים שחסר
כאנליסטים, אנחנו מאומנים לשים לב לתאים ריקים.
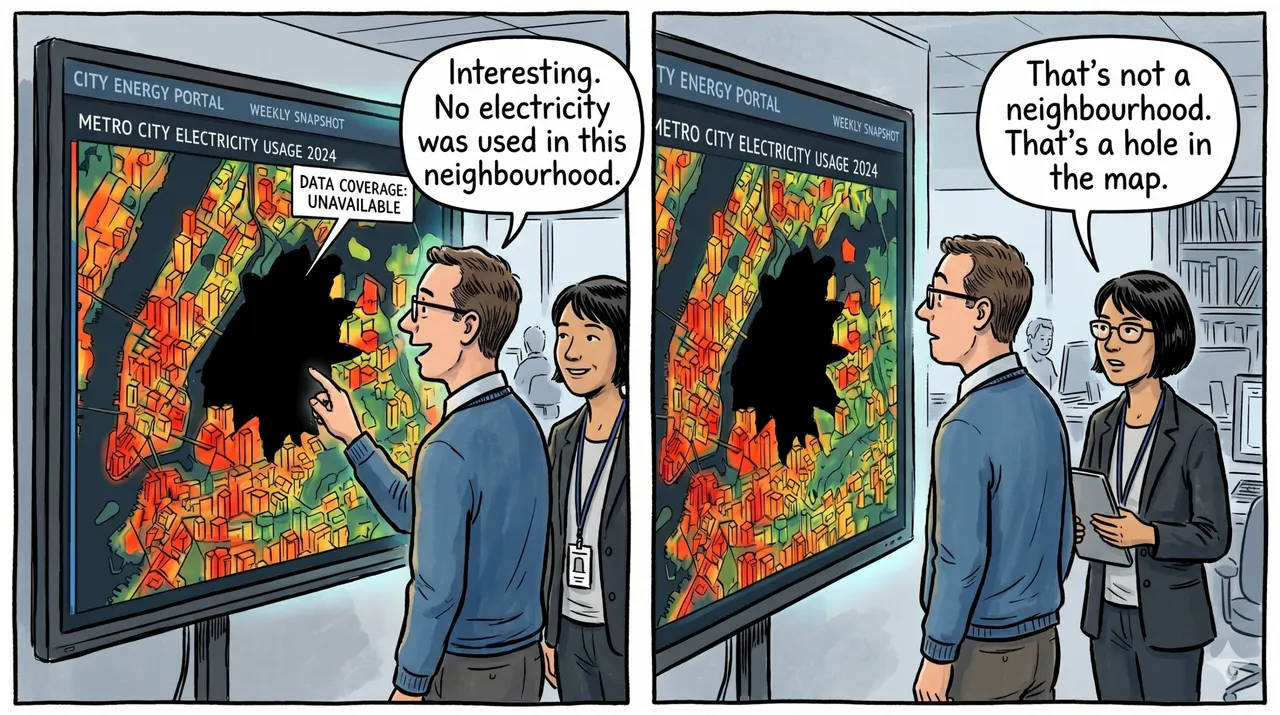
אנחנו פחות מאומנים לשים לב לכיסוי שלא קיים.
אם עמודה מלאה בערכי NULL, לפחות הבעיה מכריזה על עצמה.
אם פלטפורמה שלמה, מדינה, ערוץ או סוג אירוע נעלמים בשקט, התוצאה עדיין יכולה להיראות סבירה לחלוטין.
אם מהנדסי הדאטה שלנו כתבו "" בתא, כי הסכמה אומרת null=False, איך הייתם יודעים?
סדרת זמן לא צועקת כשהיא הופכת לחלקית.
זאת הסיבה שכשלי שלמות נתונים מייצרים לעיתים קרובות את הטעויות הבטוחות ביותר בעצמן. בדשבורד עדיין יש קווים. ל־KPI עדיין יש שתי ספרות אחרי הנקודה. הפגישה עדיין מתקיימת בזמן. החסר מסתתר בתוך הנורמליות.
״אין נתונים״ לעומת ״אפס״
עסקים מבלבלים כל הזמן בין היעדר נתונים לבין היעדר פעילות.
אפס הזמנות אומר שאף אחד לא קנה.
אין רשומות של הזמנות אומר שאתם לא יודעים אם מישהו קנה.
אפס סשנים מ־iOS אומר שאף אחד לא ביקר.
אירועי iOS חסרים אומרים שאתם לא יודעים כמה אנשים ביקרו.
אלה לא הבחנות דקות. אלה עולמות שונים.
זה לב העניין של נתונים חסרים, ובכל זאת הרבה דשבורדים משטחים את שני המצבים לאותה תוצאה חזותית: מספר נמוך.
זה חשוב כי אנשים מגיבים אחרת לאפס מאשר לאי־ודאות.
אפס מעודד פעולה. אי־ודאות אמורה לעודד בדיקה.
כשהדשבורד לא מסוגל להבחין ביניהם, צוותים ממהרים למצוא הסברים להתנהגות שאולי מעולם לא התרחשה.
לא כל הנתונים חסרים באותה צורה
ברגע ששמים לב שחסרים נתונים, השאלה הבאה היא לא רק כמה חסר. היא למה.
סטטיסטיקאים בדרך כלל מחלקים את מנגנוני החסר לשלושה סוגים רחבים:
- MCAR — Missing Completely At Random, חסר אקראי לחלוטין: לערכים החסרים אין קשר משמעותי לדאטה שנצפה או לערך החסר עצמו.
- MAR — Missing At Random, חסר אקראי: החסר קשור למשתנים אחרים שנצפו, גם אם לא ישירות לערך החסר.
- MNAR — Missing Not At Random, חסר שאינו אקראי: החסר קשור לערך החסר עצמו, או למצב הבסיסי שנמדד.
התוויות האלה נשמעות אקדמיות, עד שמבינים שהן מרמזות על סיכונים שונים מאוד.
MCAR — חסר אקראי לחלוטין
אם הדאטה חסר במנגנון MCAR, השורות החסרות מעצבנות, אבל פחות סביר שהן יטו את התוצאה באופן שיטתי. אם המנגנון הוא MAR, ייתכן שאפשר למדל את הדפוס או לתקן עבורו באמצעות משתנים שעדיין נצפים. אם הוא MNAR, החסר עצמו הוא חלק מהסיפור. כלומר, תיקונים פשוטים יכולים לגרום לאנליזה להיראות נקייה יותר בזמן שהם מרחיקים אותה עוד יותר מהאמת.
זאת אחת הדרכים המהירות ביותר שבהן אנליסטים עובדים על עצמם. הם רואים ערכים חסרים, מפעילים טיפול גנרי אחד, וממשיכים כאילו כל היעדר נתונים נוצר באותה דרך.
דוגמה 1: שירותי בריאות ו־MCAR
מערכת מעבדה בבית חולים מאבדת קבוצה קטנה של תוצאות בדיקות דם, כי מכשיר אחד יוצא מפעולה לעשרים דקות במהלך תחזוקה שגרתית. המטופלים שנפגעו מכך לא נבחרו מסיבה קלינית כלשהי. ערכי הבדיקות החסרים שלהם הם בעיקר תוצאה של חוסר מזל תפעולי.
זה קרוב ל־MCAR.
הדאטה עדיין אינו שלם, אבל פחות סביר שהחסר קשור באופן שיטתי לחומרת מצב המטופל, לגיל, לאבחנה או לתוצאת הבדיקה עצמה. עדיין צריך לטפל בזה בזהירות. אבל הסיכון הוא לא רק ערכים חסרים. הסיכון הוא ההנחה שכל רשומת בריאות חסרה משקפת התנהגות של מטופל, כשלעיתים היא פשוט משקפת חומרה שמתנהגת לא יפה.
דוגמה 2: חינוך ו־MAR
מחוז חינוך מנתח השלמת מטלות. הוא מגלה שמצב הגשת שיעורי הבית חסר לעיתים קרובות יותר אצל תלמידים בכיתות שבהן המורים אימצו פלטפורמת למידה חדשה באיחור.
זה קרוב יותר ל־MAR.
החסר אינו אקראי לחלוטין, אבל הוא קשור למשתנה שנצפה: הכיתה או אימוץ הפלטפורמה בידי המורה. אם יודעים אילו כיתות עברו מאוחר, אפשר לפחות לחשוב על ההטיה, ואולי לתקן עבורה. בלי ההקשר הזה, אתם עלולים לספר סיפור על תלמידים שלא מעורבים בלמידה, כשהבעיה האמיתית הייתה הטמעה לא אחידה של המערכת.
דוגמה 3: אשראי צרכני ו־MNAR
מלווה מבקש ממועמדים לדווח בעצמם על הכנסתם בתהליך של בדיקת התאמה ראשונית. ערכי ההכנסה החסרים מתרכזים אצל מועמדים שההכנסה שלהם משתנה יותר או נמוכה יותר, ושנוטים יותר לדלג על השאלה מאשר לחשוף תשובה לא נעימה.
זה כבר שטח קלאסי של MNAR.
החסר לא רק צמוד לרשומת הבקשה. הוא קשור לערך שלא נצפה עצמו. אנשים עם מאפייני הכנסה מסוימים נוטים יותר לא לדווח על ההכנסה בכלל. אם אתם מחליפים את התאים הריקים האלה בחציון כללי וממשיכים כאילו המדגם נשאר מייצג, לא פתרתם את הבעיה. הסוויתם אותה.
הלקח המעשי פשוט: לפני שמתקנים דאטה חסר, צריך להחליט עם איזה סוג של חסר מתמודדים. אחרת אתם מסתכנים בהתייחסות להיעדר מוטה כאילו היה פער תמים.
שלמות נתונים תלויה בשאלה, לא בטבלה
אותו דאטה יכול להיות שלם למטרה אחת ולא שלם למטרה אחרת.
אם אתם רוצים את סך ההזמנות שהושלמו אתמול, טבלת רכישות עשויה להספיק. אם אתם רוצים שיעור המרה לפי מכשיר, צריך גם דאטה אמין של סשנים לפי מכשיר. אם אתם רוצים CAC, עלות רכישת לקוח, לפי ערוץ, צריך הוצאות שאפשר לייחס לערוץ, סשנים, המרות ומטא־דאטה עקבי של קמפיינים.
שלמות נתונים היא לא תכונה שמעניקים לטבלה פעם אחת ואז ממשיכים הלאה. היא מותנית.
שלם בשביל מה?
באיזה טווח זמן? עבור אילו ישויות? באיזו רמת פירוט?
כאן הדאטה ה״נקי״ שלכם יכול להיכשל. הוא שלם מספיק כדי להתקיים בפרודקשן, אבל לא שלם מספיק כדי לענות על השאלה העסקית שנשאלת כרגע.
איך עלולים לפספס את זה
מתחילים מהמדד במקום מהכיסוי, ושואלים:
- מהו שיעור ההמרה השבוע?
- איזה ערוץ ירד?
- האם המובייל מציג ביצועים חלשים?
במקום זה, לפני תחילת האנליזה, שאלו:
- האם יש לנו כיסוי לכל התאריכים הרלוונטיים?
- האם כל הפלטפורמות עדיין שולחות את האירועים שאנחנו צריכים?
- האם שחרור גרסה, מעבר מערכת או שינוי ספק שינו את מה שנאסף?
- האם מדינות, ערוצים או פלחי לקוחות מסוימים חסרים לגמרי, או שהכול כפי שאנחנו מצפים שיהיה?
אנחנו עלולים לפספס שלמות נתונים גם מפני שכלים מודרניים טובים בלגרום לדאטה חלקי להרגיש רשמי. דשבורדים מציגים משהו עבור כל תקופה. מחסני נתונים מחזירים שורות. כלי BI מחשבים ממוצעים מעל החורים בשמחה. שום דבר מזה לא מוכיח שהמציאות שנצפתה שלמה מספיק כדי לתמוך בהחלטה.
מה שלמות נתונים שוברת מבחינה עסקית
כשלי שלמות נתונים לא שוברים רק דשבורדים. הם שוברים תעדוף.
צוותים עוצרים קמפיינים בריאים. צוותי מוצר חוקרים בעיות המרה מדומיינות. מנהלים מקצים כוח אדם לצוואר הבקבוק הלא נכון. כספים ושיווק מתווכחים על תוצאות, כשהמחלוקת האמיתית היא על מה שמעולם לא נאסף.
העלות העסקית היא לא ״איכות נתונים גרועה״. העלות העסקית היא תשומת לב מבוזבזת.
מרגע שזה קורה, כל שיחה חכמה שנבנית על גבי הדאטה החסר הופכת לסוג יקר של תיאטרון.
לא מספיק שהאירועים נאספו. נתונים יכולים להיות קיימים ועדיין לא להיות שמישים. הבעיה הבאה היא תקינות, validity: האם הערכים שאספתם באמת עומדים בכללים שנותנים להם משמעות.
אפשר לתרגל אנליטיקה כאן:
תקשיבו, אני בניתי את זה, אז זה חשוב לי מאוד. אבל זה המקום היחיד שאני מכיר שבו אפשר לתרגל עבודה אנליטית אמיתית. לא רק שאילתות או סקריפטים, ובלי משחקיות מזויפת שנועדה לגרום לכם להשלים עוד רצף יומי.
האתגרים שלנו יכולים לקחת זמן, ולפעמים הם לא יהיו קלים. אבל כולם מבוססים על הניסיון המצטבר שלי ושל אחרים, ועל הטעויות שעשינו בדרך: